
做大模型商业化落地这件事的时候,行业会碰到一个比较普遍的难题。平台如果把全部业务请求,都交给旗舰大模型去处理,虽然输出内容的质量可以稳住,但是推理产生的成本会不断上涨,很难放到大范围场景里面落地。本文为 AI 行业产品思路推演,文中 Astra、Sol 模型为假设方案,并非厂商正式发布产品,相关性能描述仅为理论探讨,不代表真实产品指标。
一、两款模型定位:专业任务与日常任务的分工
1.1 Astra:面向高复杂度专业任务的高端模型
在这套假设的产品方案里面,开发人员把 Astra 设定成同代里面档次更高的模型,用来处理难度偏高的专业工作。像是深度代码编写、长篇材料分析、多步骤逻辑推导、复杂项目方案设计,这类对推理精度和长文本理解要求很高的工作,都可以交给这个模型。
这类请求在全部调用量里面占的比例一般不算高,但它对模型本身能力要求比较严格,轻量模型很难稳定做好这类任务。Astra 起到的主要作用,就是提高复杂任务的输出稳定性,减少后面人工核对、修改内容的工作量。
1.2 Sol:适配高频日常任务的轻量化模型
开发人员将 Sol 当成同体系下的轻量模型,用来处理平台上面大部分普通请求。简单提问、基础文字修改、短文概括、简单表格整理、普通文案撰写,这类简单而且出现很频繁的任务,就适合交给这个轻量模型。
这个模型不会着重打磨复杂场景下的推理能力,优先保证更快的反馈速度,还有同时处理很多任务的能力。在理想的调度条件下,Sol 的理论处理速度会明显好于高端模型,更加适合大量请求同时发过来的日常业务。
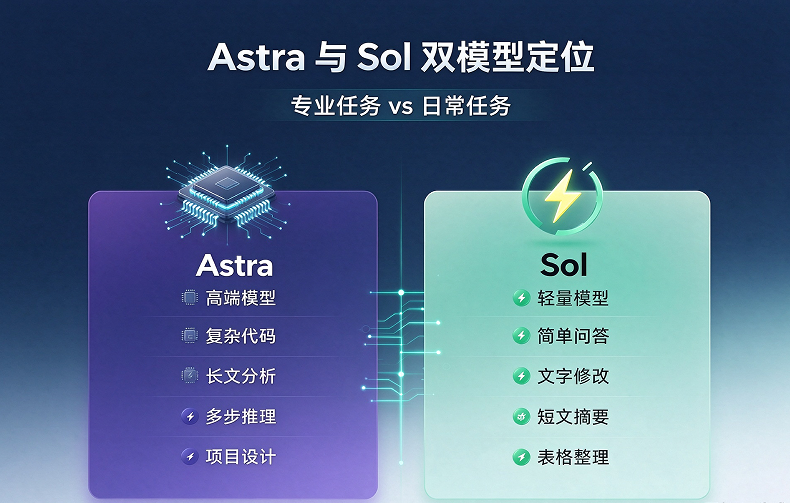
Astra 和 Sol 双模型定位对比图
二、成本分层:按任务难度调度,优化算力资源投入
双模型分层方案最核心的逻辑,就是系统跟着任务的难度,去分配对应的算力资源。
如果所有用户的请求,全都统一使用高端模型,大量简单问答、基础文字处理这类低难度任务,会一直消耗价格很高的算力,造成资源白白浪费。平台可以搭建一套任务分配机制,系统把简单请求交给轻量模型;等到系统识别到复杂专业需求的时候,再去调用高端模型。
参考行业里面常见的调用情况,平台大部分请求都属于普通日常任务,可以用低成本模型来处理;只有一小部分复杂业务,才需要启动高端模型。这套方式能够减少整体 Token 消耗,使用者在保证核心专业任务效果的基础上,控制 AI 调用产生的整体花费。
三、同代产品分档,背后的产品设计思路
3.1 同源基座设计,降低业务适配成本
文中设定 Astra 和 Sol 属于 GPT-6.2 同一代产品,二者并不是两套完全独立开发的模型,底层技术的来源是一样的,能力标准也保持统一。使用者不用去适配两套差别很大的使用规则,提示词写法、接口调用规则基本一样,能够减少开发接入和业务迁移的成本,这也是这套方案和跨代模型搭配的主要差别。
3.2 兼顾不同用户群体的使用诉求
对个人用户来说,轻量模型可以满足日常使用,保证响应稳定;当用户有深度创作、复杂逻辑推导这类需求的时候,可以切换到高端模型,同时覆盖日常使用和专业场景。
对企业客户来说,分层模型方便企业给不同业务划分预算。企业可以在核心高价值业务上选用高端模型,大批量自动处理普通任务的时候,就使用轻量模型,企业在输出效果、响应速度和预算之间找到合适的平衡点。
四、总结
这套 Astra+Sol 同代双模型方案,打破了只用单一模型处理所有任务的传统思路。方案依靠能力分层、成本分层的设计,系统按照任务难度分配对应档次的模型。
这套方案落地的时候,还有不少工程上面的难题需要解决,包括任务自动识别的准确度、两个模型输出风格保持一致、不同场景下效果波动等问题。 总的来看,大模型行业的竞争不只是比拼单个模型的测试分数,任务自动分配、成本管控、整套产品分层设计,都是商业化落地过程里面需要考虑的因素。这种同代分档的设计方式,值得行业持续关注。
免责声明:本文内容仅为 AI 行业产品思路推演,文中提及的模型、性能指标均属于假设场景,并非厂商官方披露信息,不构成技术选型、投资相关建议。