
最近一段时间,DeepSeek 推出了 Flash 系列大模型。这个系列是新架构下面的轻量化产品,官方把它的定位往旗舰级模型靠拢。本次资讯来源于 DeepSeek 官网公告和官方 API 文档,本文只是根据公开的信息做一些解读,不会判断模型性能的好坏,本文仅为资讯解读,不构成产品选购建议。
一、Flash 模型基础架构与产品定位
Flash 系列采用 MoE 混合专家架构(混合专家模型),搭配了新的非对称编解码结构,属于这套架构当中的中小型模型。产品设计主要是想提升推理速度、吞吐效率,同时降低使用成本。这个模型自带多模态视觉能力,能够识别图像里面的内容。
根据官方公开出来的资料,Flash 系列并不是用来完全替代旗舰大模型。产品想要保留基础能力的同时,减少推理过程里面消耗的算力和存储资源。在一部分基准测试场景当中,该模型表现接近旗舰水平。但是遇到难度比较高的复杂任务的时候,它和顶级旗舰模型之间还有差距。这样的产品思路,就是在模型能力、响应速度、调用成本这三者之间寻找一个平衡点。
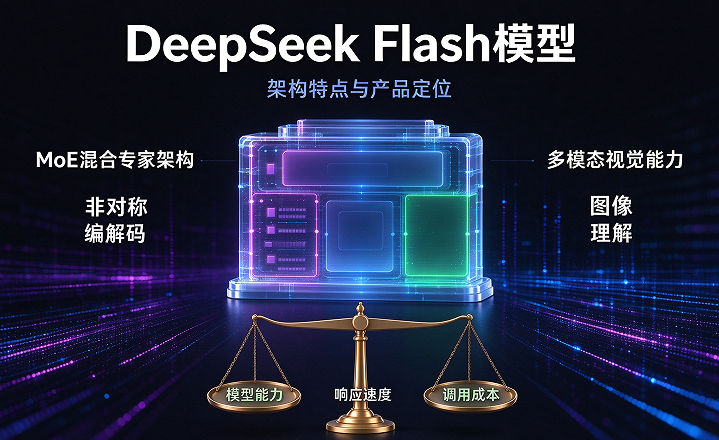
DeepSeek Flash 模型图
二、技术层面核心优化方向
Flash 系列重点优化了 KV 缓存占用情况。和旧版本模型对比来看,Flash 系列对高带宽显存和固态硬盘的资源需求明显变少。在 AI 智能体(Agent,人工智能智能体)的使用场景里,系统需要反复调用工具,去执行流程较长的任务,缓存消耗往往是产生成本的主要地方。缓存压缩技术能够减少这类场景下产生的调用花费。
DeepSeek 已经把 Flash 系列模型接入自己的 API 服务,开发者能够直接调用这个模型。官方还提到,团队会持续和开源社区开展合作,完善模型本地部署相关的适配工作,给有大规模部署需求的企业开放对应的对接渠道。旧版 Flash 相关模型已经下线,接口保留了兼容设置,方便已经上线的业务平稳完成切换。这里的切换工作,一般需要技术人员做简单调试。
三、行业层面的客观解读
从行业的角度来看,Flash 系列代表了当下大模型领域的一个发展方向。行业不再一味追求更大的参数规模,而是依靠架构上的改进,提高算力的使用效率。很多企业的 AI 应用不需要一直调用价格偏高的旗舰模型,大部分普通任务都可以用性价比更高的模型处理。Flash 这类产品,刚好符合这类市场里面的需求。
大家需要理性看待模型基准测试的结果。公开测试出来的分数只代表模型在特定数据集上面的表现。放到真实业务环境里,模型效果会受到提示词设计、业务数据、部署环境等很多条件影响。虽然官方定位对标旗舰,这不代表它在所有任务上面都能达到旗舰标准。企业落地使用之前,仍然需要结合自身场景做足够多的测试,不能直接照搬测试结果。
四、小结
DeepSeek 推出的 Flash 系列模型,是面向高效推理场景开发的多模态大模型。该模型依靠架构和缓存机制优化,试着控制成本,得到接近旗舰模型的综合能力,可以用于 API 调用和企业本地部署。
国内大模型行业慢慢不再只比拼参数大小,转而看重算力效率、落地成本和场景适配能力。Flash 系列的发布,也能够看出行业在尝试不一样的产品路线,用来满足各类 AI 开发的需求。