
不少从业者会去做一个简单的测试,从业者直接向 AI 提问,问问自己所在行业里面有哪些服务商、机构和品牌,看看 AI 最先推出来的对象是什么。现在越来越多从业者,都开始留意这个测试出来的结果。AI 给出的这个推荐排名,并不能代表行业里面各个主体真实的实力,这个结果是模型根据网上检索到的信息综合生成出来的。弄懂这个推荐背后的逻辑,可以帮助从业者理性看待 AI 输出的内容,看懂和生成式引擎优化相关的这类工作。
一、AI 给出首位推荐的底层逻辑
现在市面上主流的大模型,在回答这类行业推荐相关问题的时候,大多都会使用检索增强生成的方式。当用户提出行业选型相关问题,模型就会到互联网上面查找资料,筛选收集到的信息是否可靠,最后把收集到的全部信息整合起来,形成最后的回答。
模型本身没有办法自己去判断一家企业真实的技术水平还有服务质量。模型会优先挑选那种网上信息稳定、多个平台描述保持一致,同时还有第三方资料做佐证的主体,作为优先推荐的对象。
简单来讲,AI 更愿意推荐资料充足、出错风险更低的主体,不一定就是行业里面综合实力最强的那一个。如果某个主体,网上留存的资料比较零散,不同网页写的信息还互相冲突,就算这家主体线下业务做得很好,也很难拿到比较靠前的推荐名次。
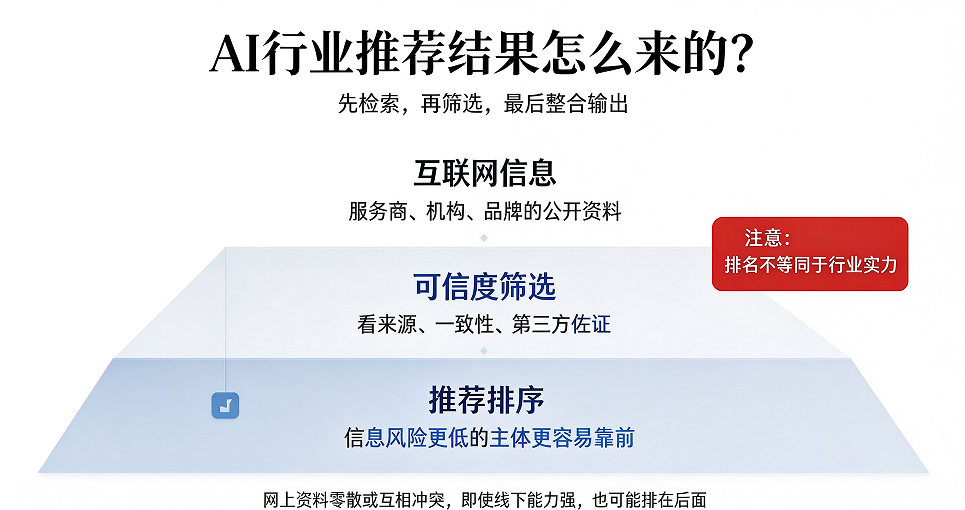
AI行业推荐结果来源图
二、影响推荐顺位的几个关键因素
(一)网络信息的丰富度与一致性
网上相关内容数量的多少,还有信息描述能不能保持统一,会直接影响检索召回出来的结果。如果一个主体,在多个正规平台上面都留有客观介绍,各类信息之间没有明显矛盾,检索系统就更容易收录这个主体的相关信息。反过来讲,如果主体在网上留下的资料很少,或者不同页面的描述差别很大,模型就会降低引用这条信息的优先级。
(二)信息来源的可信度权重
模型会给检索出来的网页划分不一样的权重。行业媒体、企业官网、百科这类比较可靠的来源,拥有更高的权重。里面带有大量营销话术、内容高度重复的低质文章,会被模型过滤掉,很难拿来当作模型参考的资料。
(三)问题表述带来的结果波动
针对同一个行业问题,用户只要稍微改动提问的文字,AI 检索获取到的内容就会发生变化,排在第一名的推荐主体也会跟着改变。所以单次测试得到的排名,只能简单拿来参考,不能当成永远不会变动的结论。
三、客观看待 AI 行业推荐结果的局限性
AI 输出的推荐内容本身,存在着一定的局限。模型只能依靠互联网已经存在的文字资料,没办法实地核查企业真实的服务情况、项目案例还有交付能力。
这里就会出现两种情况:有些主体线下业务做得扎实,但是网上信息建设做得不足,AI 就不会优先推荐;有些主体网上信息完善,排在推荐第一位,但这个排名并不能证明它就是行业里面最好的选择。
大模型会出现信息幻觉的问题,有一部分推荐的信息有可能存在偏差。从业者不能直接把 AI 给出的第一名当成权威的行业榜单。从业者需要结合线下沟通、查看真实项目案例等多种办法,交叉核验主体的真实实力。
四、从业者可以建立的理性认知
现在有很多从业者,都在关注豆包这类大模型检索出来的推荐位次,相关的生成式引擎优化工作也跟着出现。这类工作主要是完善互联网上的客观信息,帮助大模型准确识别主体信息,并不是人为干预模型,强行把目标结果放到首位。
从长远来看,AI 推荐只是我们获取信息的其中一个渠道。挑选合作对象的时候,判断的核心标准依旧是企业业务能力、过往项目案例和交付质量。AI 给出的首位推荐结果,只能当作初步参考,不能直接当成最终选择的依据。